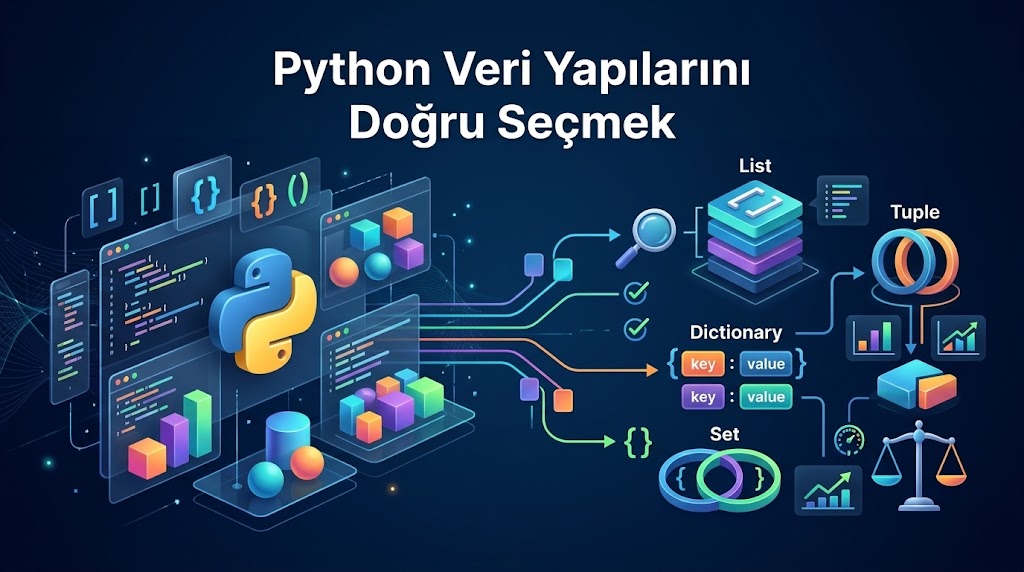
Python Veri Yapılarını Doğru Seçmek
Ders 23'te List Comprehension ile tek satırda liste üretmeyi öğrendik. Döngü yazmayı da biliyorsun artık; milyonlarca kaydı sırayla gezebilirsin. Ama şu soru hiç gündeme gelmedi: o kayıtları nerede tutuyorsun?
Bir programın hızını belirleyen şey çoğu zaman algoritma değildir. Veriyi koyduğun yapıdır. Yanlış yapıyı seçersen en akıllı döngü bile emekler; doğru yapı, imkânsız görünen işi saniyelere indirir. Yapı seçimini yaptığın an, programın hız sınırını da büyük ölçüde belirlemiş olursun. Bu ders Modül 4: Veri Yapıları'nın kapanışı; burada kazandığın sezgiyi ileride pandas'a, SQL'e, hatta mikroservis tasarımına kadar taşıyacaksın.
Dört Yapı, Tek Cümle
Python'ın iş atı dediğimiz dört yapısı var. Her birini tek cümleyle tanıyalım:
- list: Sıralı ve değişebilir liste; aynı değer birden çok kez bulunabilir.
- tuple: Sıralı ama değişmez demet; tanımlandıktan sonra içeriği kilitlenir.
- dict: Anahtar-değer çiftleri tutan sözlük; anahtarı bilirsen değere anında ulaşırsın.
- set: Benzersiz elemanlar kümesi; aynı değeri ikinci kez eklemek boşunadır.
Dört yapıyı yan yana görelim:
ogrenciler = ["Ada", "Bora", "Can"]   # list: sıralı, sonradan eleman eklenebilir
koordinat = (41.0082, 28.9784)        # tuple: sabit ikili, kimse değiştiremez
kayit = {"ad": "Ada", "yas": 21}      # dict: "ad" anahtarından "Ada" değerine ulaşırız
meyveler = {"elma", "armut", "elma"}  # set: ikinci "elma" sessizce yok sayılır
print(meyveler)                       # örnek çıktı: {'elma', 'armut'} (sıra garanti değil)
Kümede ikinci "elma" kayboldu; çünkü set, elemanların benzersiz kalmasını garanti eder. List ve tuple'da sıra hep korunur; dict ise Python 3.7'den beri ekleme sırasını hatırlar ama ona "sıralı liste" gibi davranmamalısın. Kafa karışıklığı buradan doğar: dört yapı da bir şeyler tutar, ama tutma kuralları bambaşkadır.
Hangi Durumda Hangisi?
Kuralı şöyle koyabiliriz:
- Sıralı ve değişken veri → list. Alışveriş sepeti, log satırları, öğrenci listesi.
- Sabit kalacak veri → tuple. Haftanın günleri, bir noktanın koordinatı, değişmez sabitler.
- Anahtar-değer ilişkisi → dict. TC kimlik no → kişi, ürün kodu → fiyat.
- Benzersizlik gerekli → set. Eşsiz e-posta adresleri, bir formdaki kategori listesi.
Küçük bir örnek:
# Haftanın günleri program boyunca değişmemeli: tuple doğru seçim
HAFTA_GUNLERI = ("Pazartesi", "Salı", "Çarşamba", "Perşembe", "Cuma")

# log_satirlari: log dosyasından okunmuş satırların listesi (tanımı önceki derste kaldı)
gorulen_sehirler = set()
for satir in log_satirlari:
    sehir = satir.split(",")[2]      # üçüncü alan şehir bilgisi
    gorulen_sehirler.add(sehir)      # "İstanbul" 40 kez gelse bile bir kez sayılır
add çağrısı tekrar eden değerlerde hiçbir şey yapmaz; böylece "acaba bu şehri daha önce ekledim mi?" diye ayrıca kontrol yazmaktan kurtulursun. Tuple seçimi ise başlı başına bir mesajdır: "bu değerler sabittir, kimse değiştirmeye kalkmasın." Kodu okuyan arkadaşın bu mesajı bilinçsizce alır. Küçük bir hafıza detayı daha: tuple, list'e göre azıcık daha az yer kaplar ve değişmez olduğu için dict anahtarı olabilir; list olamaz.
Yanlış seçimin faturası da hemen kesilir. Benzersiz e-posta için list kullanırsan kopyalar sessizce birikir; menü sırasını dict'te tutarsan sıralama bir gün kayar. Yapıyı, ihtiyaçtan şikâyet edince değil; ihtiyacı tanımlayıp hemen seçince doğru yerine oturtursun.
Arama Performansı: Sezgiyi Kur
in operatörü iki yapıda bambaşka çalışır. Listede tarama vardır; set ve dict'te ise hash tablosu.
import time

kayitlar = list(range(1_000_000))   # 1 milyon kaydı listeye koyuyoruz
kume = set(kayitlar)                # aynı kayıtları bir de kümeye taşıyoruz
aranan = 999_999                    # listenin en sonundaki değeri arayacağız

basla = time.perf_counter()
bulundu = aranan in kayitlar        # liste: 0'dan başlayıp tek tek karşılaştırır
print("Listede arama:", round(time.perf_counter() - basla, 4), "saniye")

basla = time.perf_counter()
bulundu2 = aranan in kume           # küme: değeri hash'ler, tek adımda cevap verir
print("Kümede arama:", round(time.perf_counter() - basla, 4), "saniye")
Liste araması en kötü durumda bütün elemanları gezer; aradığın değer sonda olduğu için burada tam tur attı. Küme ise değeri önce bir hash değerine çevirir, sonra doğrudan ilgili bölmeye bakar; eleman sayısı bir milyon olsa da iş neredeyse anlık biter. Bilgisayar bilimi diliyle: liste araması O(n), set ve dict araması ortalama O(1). n büyüdükçe aradaki uçurum da büyür; ölçeklenmeyi planlayan her sistemde bu seçim kritiktir.
Şimdi acı tecrübeye geliyorum. 2015 yılıydı; bir e-ticaret firmasında stok güncelleme betiği yazıyordum. Tedarikçiden gelen dosyadaki her ürün için şunu çalıştırıyordum: if barkod in mevcut_stok_listesi. Liste bir milyon kayıt tutuyordu. Sonuç? Betik altı saatte bitiyordu. Döngüyü optimize ettim, dosya okumayı hızlandırdım, logları azalttım; hiçbiri işe yaramadı. Saatler sonra sorunun döngüde değil, yapıda olduğunu gördüm. Listeyi bir kez kümeye çevirip aynı satırı çalıştırdım: üç dakika. Altı saatten üç dakikaya. O günden beri "bu koleksiyonda arama mı yapacağım?" sorusu parmaklarımda otomatikleşti.
Bir de stajyer anım var. Genç arkadaş kampanya listesi için benzersiz e-posta toplayacaktı; liste.append(mail) yazmış, "aynı müşteri üç dosyada geçiyor" diye hiç düşünmemişti. Rapor, müşteri sayısını üç kat göstermeye başladı. Hatanın bulunması yarım saat sürdü; çözümü tek satırdı: kume.add(mail). append benzersizlik vaat etmez; add eder. Yapı seçimi, doğruluk garantilerini de beraberinde getirir.
Karar Akışı: Önce İhtiyacı Tanımla
Yapı seçimini hisse bırakma; sorularla yap. Sırayla kendine sor:
- Sıra önemli mi? Önemliyse list ya da tuple'a yönel.
- İçerik değişecek mi? Değişecekse list, değişmeyecekse tuple.
- Veriye nasıl ulaşacağım? İndisle → list/tuple; anlamlı bir anahtarla → dict.
- Tekrar eden değer olabilir mi? Olabilir → list; olmamalı → set.
- Sık arama yapacak mıyım? Yapacaksan set ya da dict düşün.
Bu beş soru kutsal bir şema değil; ama hepsini sorduğunda yanlış yapı seçme ihtimalin ciddi biçimde düşer. İhtiyacı tek cümleyle yazmak da aynı işi görür:
# "Kullanıcının takip ettiği kategoriler; sıra önemsiz, aynısı iki kez olmasın."
takip_edilenler = {"spor", "teknoloji"}    # -> set

# "Sınav sonuçları; öğrenci numarasına göre erişeceğim."
sonuclar = {101: 87, 102: 92, 103: 78}     # -> dict

# "Sepetteki ürünler; ekleme sırası görünsün, aynı ürün tekrar edebilir."
sepet = ["klavye", "fare", "klavye"]       # -> list
Cümledeki her sıfat bir yapıya işaret eder: "sıra önemsiz" → set, "numaraya göre" → dict, "sırası görünsün" → list. İhtiyacı yazamıyorsan yapıyı da seçemezsin; önce ihtiyacı netleştir, kod kendiliğinden şekillenir.
Bir de şunu bil: yanlış seçimi sonradan değiştirmek her zaman mümkün. list(kume) yazarsın, veri listeye döner; set(liste) ile küme olur. Ama dönüşümün de bir maliyeti var; milyonluk bir listeyi kümeye çevirmek, o ilk seferde bir kez tam tarama yapar. Kararı baştan verirsen bu maliyeti de ödemezsin.
Karma Örnek: Öğrenci Kayıt Sistemi
Gerçek sistemler tek yapıyla yetinmez. En yaygın desenlerden biri dict listesidir; her kayıt bir sözlük, kayıtların tamamı bir listede durur:
# Her öğrenci bir dict; tüm kayıtlar tek listede tutulur
ogrenciler = [
    {"no": 101, "ad": "Ada", "bolum": "Bilgisayar"},
    {"no": 102, "ad": "Bora", "bolum": "Elektrik"},
    {"no": 103, "ad": "Can", "bolum": "Bilgisayar"},
]

# Sık sorgulanan alan için ayrıca bir indeks sözlüğü kuruyoruz
indeks = {ogrenci["no"]: ogrenci for ogrenci in ogrenciler}

# Yeni kayıt eklendiğinde iki yapıyı birden güncellemek gerekiyor
yeni = {"no": 104, "ad": "Deniz", "bolum": "Makine"}
ogrenciler.append(yeni)      # liste: listeleme ve sıralama için
indeks[yeni["no"]] = yeni    # dict: numaradan anında erişim için

print(indeks[102]["ad"])     # "Bora" — tek adımda bulunur
Liste, kayıtların listeleme sırasını taşır; sözlük ise "102 numara kim?" sorusunu taramadan cevaplar. Bu desen, veritabanlarının kaputun altında yaptığının birebir aynısıdır: tablo sıralı satırlardır, indeks ise anahtar-değer haritası. Öğrenci sayısı yüz binlere çıkarsa her sorguda for ogrenci in ogrenciler ile liste taramak sistemi yavaşlatır; o yüzden sorgulanacak alanı baştan indeksle.
Kayıt silme ve güncellemede de aynı disiplin geçerli: listeden çıkardığın öğrenciyi indeksten de del indeks[no] ile silmen gerekir. İki yapıdan biri geride kalırsa, uygulama bazen doğru bazen hatalı davranan o meşhur "bazen çalışan" bug'a dönüşür.
Pandas Köprüsü: Veri Biliminin Temeli Burada
İleride veri bilimi modülünde pandas'la saatler geçireceksin. Şimdiden söyleyeyim: pandas bu dört yapının omuzlarına kurulmuştur.
- Bir
DataFramein sütunları, isimle erişilen dict benzeri yapılardır;df["yas"]yazdığında sözlükten değer çekiyormuş gibi hissedersin. - Satır ve sütun indeksleri (
Index) altında hash tabanlı arama çalışır; bu yüzden.loc[...]milyon satırda bile hızlıdır. - Her sütun bir
Seriestir; o da NumPy dizisi üzerine kuruludur ve list gibi sıralıdır.
Küçük bir tat:
import pandas as pd

df = pd.DataFrame(ogrenciler)                # dict listesi doğrudan tabloya dönüşür
bilgisayar = df[df["bolum"] == "Bilgisayar"] # sütundan filtreleme yapıyoruz
print(bilgisayar)
DataFrame oluştururken az önceki dict listesini olduğu gibi verdik; pandas her anahtarı sütuna, her sözlüğü satıra çevirdi. Filtreleme ise sütun değerlerini vektörel olarak karşılaştırır; senin in ile satır satır taramana gerek kalmaz. Yani bu dersteki sezgi, birkaç modül sonra doğrudan işe yarayacak.
Bu indeks mantığı SQL tarafında da aynıdır; JOIN sorgusu yavaşladığında veritabanı yöneticisinin ilk baktığı yer eksik indekstir. Yapı seçimi sezgisi, dil değiştirsen bile seninle kalır.
Sık Sorulan Sorular
Tuple'ı ne zaman listeye tercih etmeliyim?
Değerler programın ömrü boyunca değişmeyecekse tuple seç. Haftanın günleri, sabit API anahtarları, bir noktanın koordinatı gibi. Tuple, "bu veri değişmemeli" niyetini kod okuyana ilan eder; ayrıca listeye göre biraz daha az bellek tüketir.
Set'ten elemanları sıralı alabilir miyim?
Hayır; set sıra garanti etmez. Sıralı çıktı istiyorsan sorted(kume) yaz, elemanları sıralanmış bir liste olarak alırsın. Ama ekleme sırasını geri istiyorsan baştan list kullanmalıydın.
Hem sıra hem hız gerekiyorsa ne yapmalıyım?
İkisini ayrı yapılarla taşı. Sırayı list, hızlı aramayı dict ya da set tutsun; yukarıdaki öğrenci kayıt örneğindeki gibi. Güncellemelerde iki yapıyı birlikte değiştirmeyi unutma, yoksa indeks yalan söylemeye başlar.
Sırada Ne Var?
Yapı seçimini öğrendin; artık veriyi doğru yerde tutuyorsun. Ama fark ettin mi: kod büyüdükçe aynı mantık farklı yerlerde tekrar etmeye başlıyor. Sıralama şurada, filtreleme burada, aynı hesaplama üçüncü dosyada. İşte bir sonraki ders tam bu dağınıklığa giriyor: Fonksiyon Tanımlama ve Parametreler ile tekrar eden kodu tek yere taşımayı öğreneceksin. Kodun da verin kadar düzenli olacak.