Python Sets (Kümeler)
Kümeler (Sets)
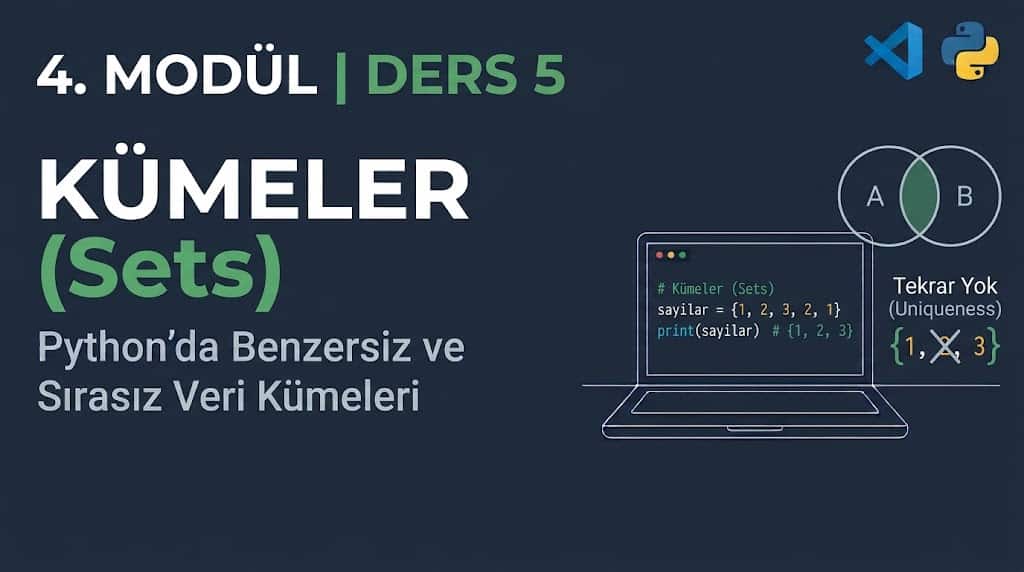
Ders 21'de sözlükleri işledik; anahtar-değer çiftleriyle veri eşleştirmeyi, bir anahtara bakıp değerini almayı öğrendin. Şimdi Modül 4'ün biraz "asi" üyesi sırada: kümeler. Sözlükler gibi kümeler de bir hash tablosu üzerinde yaşar; ama işleri bambaşkadır. Küme tek bir şey yapar ve onu kusursuz yapar: her elemandan yalnızca bir tane bulundurur.
Peki bu kadar mı? Değil. Küme aynı zamanda sırasızdır, üyelik testini şaşırtıcı bir hızla yapar ve üzerinde matematikten tanıdığın bütün işlemleri destekler. Birleşim, kesişim, fark… Hepsi hazır. Bu seride en sık göz ardı edilen ama pratikte en çok iş kurtaran veri yapısı hangisi dersen, cevabım değişmez: küme.
Küme Nedir?
Matematikteki küme kavramını düşün. {1, 2, 3} ile {3, 2, 1} aynı kümedir; sıra diye bir şey yoktur. Python'da da durum birebir böyle.
- Benzersizlik: Bir eleman kümede ya vardır ya yoktur. İkinci kez eklemeye çalışırsan hiçbir şey olmaz; hata da almazsın, kopya da oluşmaz.
- Sırasızlık: Elemanların "konumu" yoktur.
kume[0]yazamazsın; indeksleme diye bir kavram kümelerde geçmez. - Hız:
eleman in kumetesti, kümenin büyüklüğünden neredeyse bağımsız çalışır. - Değiştirilebilirlik: Eleman ekleyip silebilirsin; ama eklediğin elemanların kendisi değiştirilemez türden olmalıdır.
Yani "bu veride hangi benzersiz değerler var?" sorusunun cevabı kümedir. Milyon kayıtlık bir listede tekrar edenleri bulmak için iç içe döngü yazan birini görürsen, elindeki kümeyi hatırlat ona.
Küme Oluşturma
İki yol var: set() fonksiyonu ve süslü parantezler. Ama dikkatli ol; boş küme süslü parantezle kurulmaz.
# 1. Yol: set() fonksiyonu; herhangi bir iterable'ı kümeye çevirir
meyveler = set(["elma", "armut", "elma", "kiraz"])
print(meyveler)  # {"elma", "armut", "kiraz"} benzeri çıktı; "elma" bir kez yer alır

# 2. Yol: süslü parantezler; elemanlar virgülle ayrılır
renkler = {"kırmızı", "mavi", "yeşil"}

# DİKKAT: {} boş SÖZLÜK üretir, boş küme değil!
bos_kume = set()
Burada ilk satırda listeyi geçerken tekrar eden "elma" daha kurulum anında elendi; küme oluşurken benzersizleştirme zaten yapılır. Boş süslü parantezin sözlük üretmesi de Python'ın en klasik tuzaklarından biridir; çünkü {} sözdizimini sözlükler yıllar önce "kaptı" ve kümeye boş küme için sadece set() kaldı.
Eleman Ekleme ve Silme: add, remove, discard
kume = {"python", "java"}

kume.add("go")        # Yeni eleman ekler; "go" zaten varsa hiçbir şey değişmez
kume.remove("java")   # Eleman YOKSA KeyError fırlatır
kume.discard("ruby")  # Eleman yoksa sessizce geçer; asla hata vermez

print(kume)  # {"python", "go"}
remove ile discard arasındaki tek fark, olmayan eleman karşısındaki tavırdır. remove "bu eleman kesin olmalı" dediğin yerde kullanılır; eleman yoksa programı bilerek patlatır ve sana bir mantık hatası olduğunu haykırır. discard ise "varsa sil, yoksa umurumda değil" tavrıdır; toplu temizlik işlerinde hayat kurtarır.
Bu ayrımı ilk kez production'da, gece 03:00'te öğrendim. Otomatik bir temizlik scripti remove() çağırıyordu; veri kaynağı o gece bir kaydı eksik gönderdi, KeyError fırladı ve batch yarım kaldı. Sabah kalkıp discard()'e çevirdim; bir daha o satır yüzünden gece yarısı uyanmadım. Böyle küçük farklar, üretim ortamında büyük uykular kurtarır.
Bir de şunu bil: pop() kümeye uygulanabilir ama hangi elemanı çıkaracağı belirsizdir; küme sırasız olduğu için "ilk eleman" diye bir şey yoktur. Bir elemanı hem çıkarmak hem değerini almak istersen, çıkanın hangisi olduğunu bilmeyeceğini peşinen kabul et.
Küme İşlemleri: Birleşim, Kesişim, Fark, Simetrik Fark
Küme teorisini bilen için bu bölüm çocuk oyuncağı. Operatörler bile matematikten alınmış: |, &, -, ^.
a = {1, 2, 3, 4}
b = {3, 4, 5, 6}

birlesim = a | b          # {1, 2, 3, 4, 5, 6} — iki kümenin tüm elemanları
kesisim = a & b           # {3, 4} — yalnızca iki tarafta da olanlar
fark = a - b              # {1, 2} — a'da olup b'de olmayanlar
simetrik_fark = a ^ b     # {1, 2, 5, 6} — yalnızca bir tarafta olanlar

# Aynı işlemler metotlarla da yapılır; okunabilirlik tercihine kalmış
print(a.union(b))                # birleşim
print(a.intersection(b))         # kesişim
print(a.difference(b))           # fark
print(a.symmetric_difference(b)) # simetrik fark
Önemli ayrıntı: bütün bu operatörler yeni bir küme döndürür; a ve b olduğu gibi kalır. İki takipçi listesinden ortak takipçileri bulmak istediğinde listeleri & ile kesiştiremezsin; önce kümelere çevirir, sonra işlemi yaparsın. Orijinal verilerin elinde kalır, istatistiklerin de hazır olur.
Alt küme sorguları da aynı sezgisellikte gelir: a <= b "a, b'nin alt kümesi mi?" sorusudur, a < b ise "özel alt küme mi?" — yani a, b'nin içinde ama ona eşit değil. a >= b ile üst küme tarafını da sorgulayabilirsin. Bunlar bir satırlık kontrol ama veri kümelerini karşılaştıran her raporda kullanılır.
Metotların çoğu yeni küme döndürür ama update istisnadır: a.update(b) çağrısı b'nin elemanlarını doğrudan a'nın içine ekler, yani a değişir. Operatör karşılığı da vardır: a |= b yerinde birleşim yapar. Hangisini seçeceğin niyete bağlı; orijinal veriyi koruman gerekiyorsa yeni küme üret, elinde sürekli büyüyen bir toplayıcı varsa yerinde güncelle.
Sırasızlık Gerçeği
Küme sırasızdır dedik. Ama bu laf, başına gelene kadar hafif kalıyor. Bana 2016'da geldi.
Bir raporlama scripti yazıyordum; benzersiz müşteri ID'lerini bir kümeye atıp for döngüsüyle rapora basıyordum. Çıktı şans eseri hep küçükten büyüğe sıralı görünüyordu — çünkü küçük tam sayıların hash değeri kendisidir, yani Python onları çoğu zaman "sıralı gibi" yerleştirir. Sonra 50 bin kayıtlık gerçek veri geldi ve rapor karmakarışık oldu. İki saat "sıralamayı nerede unuttum" diye kod aradım. Sorun kodda değildi; beklentimdeydi. Set'ten sıra bekliyordum.
# Küçük tam sayılarla çalışırken sıra "normal" görünebilir...
kucuk = {1, 2, 3, 4, 5}
print(kucuk)  # {1, 2, 3, 4, 5} gibi görünür — ama bu bir GARANTİ DEĞİL

# Büyük ya da karışık değerlerde sıra tamamen öngörülemez olur
buyuk = {17, 89234, 55, 431, 9}
print(buyuk)  # muhtemelen yazdığın sıradan tamamen farklı basar

# Sıralı istiyorsan bunu AÇIKÇA sen istemelisin
sirali = sorted(buyuk)
print(sirali)  # [9, 17, 55, 431, 89234]
Arka planda şu dönüyor: küme, elemanları hash değerlerine göre bir tabloya dağıtır. Elemanın tabloda nereye düşeceği değerine bağlıdır, ekleme sırana değil. Küçük tam sayıların hash'i kendisi olduğu için "sanki sıralıymış" yanılsaması doğar; büyük sayılarda tablo farklı davranır ve yanılsama paramparça olur. Sıra lazımsa sorted() senin dostun; onu kullanmayı unutmak da en yaygın küme bug'ıdır.
Pratik: Listeden Tekrarları Temizlemek
Kümelerin en yaygın kullanım yeri burası. Bir listedeki tekrarları silmenin en kısa yolu, kümeye çevirip geri almaktır.
kayitlar = ["ali", "veli", "ali", "can", "veli", "veli"]
benzersiz = list(set(kayitlar))
print(benzersiz)  # ["veli", "can", "ali"] gibi — SIRA KORUNMAZ!
Tek satır, iş tamam. Ama bedeli var: sıra bozulur. Çıktı sana "veli, can, ali" döndürebilir; bu bir bug değil, kümenin doğasıdır. Sıra önemliyse şu numarayı kullan:
# Sırayı koruyarak tekrarları temizleme: dict.fromkeys numarası
kayitlar = ["ali", "veli", "ali", "can", "veli"]
sirali_benzersiz = list(dict.fromkeys(kayitlar))
print(sirali_benzersiz)  # ["ali", "veli", "can"] — ilk görülme sırası korunur
Burada dict.fromkeys sözlük anahtarlarının benzersiz olmasından faydalanıyor; anahtar sırası da Python 3.7'den beri ekleme sırasıdır. Kümenin hızı ile sözlüğün sıra garantisini birleştiren şık bir numara.
Bir de şu var: küme temizliği içerik temizliği değildir. Stajyerliğimde bir e-posta listesini set() ile tekilleştirip "artık tekrar yok" raporu verdim. Meğer [email protected] ile [email protected] küme için iki farklı elemanmış; büyük-küçük harf farkı yüzünden tekrarlar aynen kaldı ve haftalık bülten bazı müşterilere iki kez gitti. Ders çıkardım: önce veriyi temizle — boşlukları al, harfleri eşitle — sonra kümeye at. Kümeye giren kirlilik, kümede sessizce büyür.
Üyelik Testinin Hızı
Kümenin bir süper gücü daha var: in operatörü. Listede eleman aramak baştan sona tarama demektir; milyon kayıtta bu, milyon karşılaştırma demek. Kümede ise hash hesabı yapılır ve doğrudan doğru adrese bakılır.
buyuk_liste = list(range(1_000_000))
buyuk_kume = set(buyuk_liste)

aranan = 999_999
print(aranan in buyuk_liste)  # True — ama her seferinde uzun bir tarama yapar
print(aranan in buyuk_kume)   # True — hash ile doğrudan adrese bakar
Arkada şu oluyor: Python aradığın değerin hash'ini hesaplayıp tabloda o konuma bakıyor; eleman oradaysa iş biter. Listede ise eşleşme bulunana kadar her eleman tek tek karşılaştırılır. "Bu ID veri tabanında var mı?" gibi binlerce kez sorulan sorularda küme, çalışma süresini dakikalardan saniyelere indirir. Bedeli ise bellektir; küme, listeye göre daha çok yer kaplar. Hız mı, hafıza mı — senaryon hangisini istiyorsa onu seç.
Bonus: Donuk Kümeler (frozenset)
Normal kümeler değiştirilebilir olduğu için sözlük anahtarı olamaz; {{1, 2}: "değer"} yazarsan TypeError yersin. Burada devreye frozenset girer: kümenin değiştirilemez ikizi.
# frozenset değiştirilemez; bu yüzden hash'lenebilir ve sözlük anahtarı olabilir
donuk = frozenset([1, 2, 3])
eslestirme = {donuk: "matematik kümesi"}
print(eslestirme[frozenset([2, 1, 3])])  # "matematik kümesi" — sıra önemsizdir
Arkada şu var: frozenset elemanlarını aynı hash tablosuna yerleştirir ama add ve remove gibi metotları taşımaz; bu yüzden hash değeri sabittir ve sözlük anahtarı olabilir. Küme işlemlerinin tamamı (birleşim, kesişim, fark) donuk kümelerde de çalışır; yalnızca sonucu değiştirmek istediğinde yeni bir normal küme kurarsın. İlk başta kenara koy; günün birinde "bir küme grubunu sözlükte indekslemem lazım" dediğin an geri dönersin.
Sık Sorulan Sorular
Kümede sıralı veri saklayabilir miyim?
Hayır; küme kavramsal olarak sırasızdır ve Python bunu garanti etmez. Sıralı ve benzersiz istiyorsan sorted(set(x)) ile sıralı liste üret ya da sırayı koruyan dict.fromkeys numarasını kullan.
Liste ile küme arasında nasıl seçim yaparım?
Sıra ve tekrarlar önemliyse liste; yalnızca benzersizlik ve hızlı üyelik testi gerekiyorsa küme. İkisi birden gerekiyorsa sözlük ya da hibrit yaklaşımlar devreye girer; bu seçim işini modülün sonunda derinlemesine konuşacağız.
Kümeye liste ekleyebilir miyim?
Hayır. Küme elemanları hash'lenebilir olmalıdır; liste değiştirilebilir olduğu için hash'i yoktur ve TypeError alırsın. Ama demet ekleyebilirsin, çünkü demet değişmezdir. Aynı kuralın sözlük anahtarları için de geçerli olduğunu Ders 21'den hatırla.
Sırada Ne Var?
Kümelerle listenin sırtındaki tekrar yükünü sıfırladın. Sırada daha zarif bir iş var: listeleri döngü yazmadan, tek satırda kurmak. Bir sonraki derste List Comprehension ile tanışacaksın; orada "boş liste + for + append" alışkanlığını bırakıp Python'un en sevilen sözdizimini öğreneceksin. O zamana kadar bir küme kur, içine birkaç şey at, sırasını izle. Deneyim en iyi öğretmendir.