Parametre ve İstatistik Kavramları: Anakütle ve Örneklem Özetleri
Önceki derste anakütle ile örneklemi ayırdık. Şimdi bu iki kümeden çıkardığımız özet sayılara bakıyoruz. İstatistik metinlerini zorlaştıran şeylerden biri, aynı özetin farklı harflerle yazılması. μ, x̄, σ, s… Hangisi neyin yerine geçiyor?
Bu dersin sonunda bu harflere bakınca ne anlatıldığını göreceksin.
Parametre Nedir?
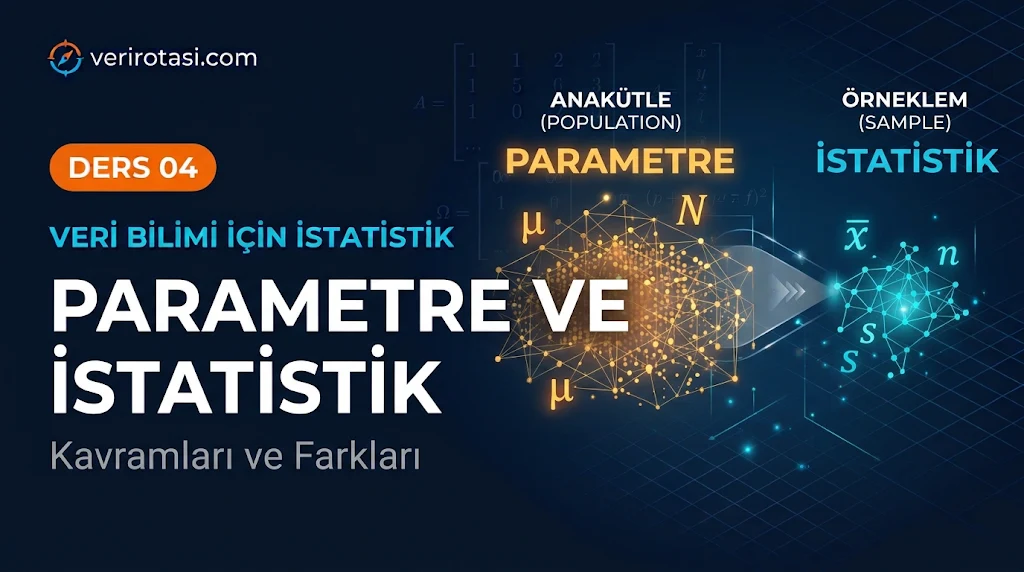
Parametre, anakütleyi tanımlayan sabit bir sayısal özettir. Gerçek değerdir ama çoğu zaman bilinmez.
Örnekler:
- Türkiye’deki tüm yetişkinlerin gerçek ortalama boyu
- Bir uygulamanın tüm kullanıcılarının gerçek aylık churn oranı
- Fabrikadaki tüm ürünlerin hata oranı
Parametre tek bir sayıdır ve değişmez. Sadece biz onu bilmiyoruz.
İstatistik Nedir?
İstatistik (burada sayı anlamında), örneklemden hesaplanan sayısal özettir. Parametreyi tahmin etmek için kullanılır.
Örnekler:
- Ankete katılan 1.000 kişinin ortalama boyu
- Son 30 günlük kullanıcı örneklemindeki churn oranı
- Kalite kontrolden geçen 500 üründeki hata oranı
İstatistik bilinen bir sayıdır. Ama her örneklemde farklı çıkar.
Bir kelimeye iki anlam yüklendiğini fark etmiş olabilirsin. “İstatistik” hem bilimin adı hem de örneklemden hesaplanan sayı demek. Bağlamdan anlarsın.
Gösterim Tablosu
| Özet | Parametre (anakütle) | İstatistik (örneklem) |
|---|---|---|
| Ortalama | μ (mu) | x̄ (x-bar) |
| Standart sapma | σ (sigma) | s |
| Varyans | σ² | s² |
| Oran | p | p̂ (p-hat) |
| Büyüklük | N | n |
| Korelasyon | ρ (rho) | r |
Kural basit: Yunan harfleri anakütleye, Latin harfleri örnekleme aittir. Şapka (^) genellikle “tahmin edilen değer” anlamına gelir.
Kestirici (Estimator) Kavramı
Parametreyi tahmin etmek için kullandığın kurala kestirici denir. Örneklem ortalaması, anakütle ortalamasının kestiricisidir. Bir kestiricinin sana verdiği belirli sayıya ise kestirim (estimate) denir.
İyi bir kestiriciden üç beklenti vardır:
- Yansızlık: Birçok örneklem üzerinde ortalamada gerçek değeri bulur.
- Tutarlılık: Örneklem büyüdükçe gerçek değere yaklaşır.
- Etkinlik: Diğer yansız kestiricilere göre daha az yayılır.
Detayları Modül 5’te ele alacağız. Şimdilik “hesapladığım sayı rastgele bir örnekleme bağlı” fikrini edin yeter.
Neden n yerine n-1 ile Bölüyoruz?
Standart sapma ve varyans hesaplarken karşına çıkan bu detay, stajyerlerin en çok sorduğu sorulardan biri.
Anakütle varyansı şöyle hesaplanır:
σ² = Σ(xᵢ − μ)² / N
Örneklem varyansında ise:
s² = Σ(xᵢ − x̄)² / (n − 1)
Neden? Örneklem ortalaması x̄, tanımı gereği o örneklemin verilerine en yakın noktadır. Gerçek μ’ye göre hesaplasaydın kareler toplamı daha büyük çıkardı. Yani x̄ kullanarak hesapladığın yayılım, gerçek yayılımı olduğundan küçük gösterir. n-1 ile bölmek (Bessel düzeltmesi) bu küçülmeyi telafi eder.
Python ve R’da Fark
import numpy as np

x = np.array([12, 15, 14, 10, 18, 20, 13, 16])

print("n ile bölünen varyans:    ", np.var(x))            # ddof=0
print("n-1 ile bölünen varyans:  ", np.var(x, ddof=1))    # örneklem varyansı
print("n-1 ile standart sapma:   ", np.std(x, ddof=1))
x <- c(12, 15, 14, 10, 18, 20, 13, 16)
var(x) # R varsayılan olarak n-1 kullanır
sd(x)İşte tuzak burada. NumPy varsayılan olarak n ile böler, R ve pandas ise n-1 ile böler. Aynı veriyle iki araç farklı sonuç verdiğinde şaşırma. Parametreyi ddof ile kendin belirle.
Simülasyonla Kanıtlayalım
Düzeltmenin gerçekten işe yaradığını görmek istersen şu denemeyi çalıştır:
rng = np.random.default_rng(1)
anakutle = rng.normal(loc=50, scale=10, size=200_000)   # gerçek varyans ≈ 100

v_n, v_n1 = [], []
for _ in range(5000):
    orn = rng.choice(anakutle, size=5)
    v_n.append(np.var(orn, ddof=0))
    v_n1.append(np.var(orn, ddof=1))

print("Gerçek varyans:", round(anakutle.var(), 1))
print("n ile bölme ortalaması:  ", round(np.mean(v_n), 1))
print("n-1 ile bölme ortalaması:", round(np.mean(v_n1), 1))
n ile bölen kestirici ortalamada gerçeğin altında, n-1 ile bölen ise gerçeğe yakın çıkacak. Küçük örneklemde fark daha belirgindir.
Örnekleme Dağılımı: Bir İstatistiğin de Dağılımı Vardır
Önemli bir düşünce kaydırması: Parametre sabittir. İstatistik ise rastgeledir, çünkü hangi örneklemi çektiğine bağlıdır. Yüz farklı örneklem çekersen yüz farklı x̄ elde edersin. Bu x̄ değerlerinin dağılımına örnekleme dağılımı denir.
Bu fikir, güven aralıklarının ve hipotez testlerinin temelidir. Bir sonuca bakıp “ortalama 52.3” dediğinde aslında “52.3, bu örnekleme dağılımından çektiğim tek bir değer” demiş olursun.
Veri Biliminde Kullanımı
- Model metrikleri: Test setinde ölçtüğün doğruluk bir istatistiktir. Modelin gerçek dünyadaki doğruluğu ise bir parametredir. İlki ikincinin tahmin edilmiş halidir.
- A/B testleri: İki gruptaki dönüşüm oranları birer istatistiktir. Asıl merak edilen, tüm kullanıcılar için gerçek farktır.
- Özellik standardizasyonu: Eğitim verisinin ortalama ve standart sapması istatistiktir. Bu değerleri test verisine de aynen uygularsın.
Acı Tecrübe: Tek Bir Sayıya Aşırı Güven
Çalıştığım bir ekipte model doğruluğu bir deneme setinde %88 çıkmıştı. Rapora net biçimde “%88” yazıldı. Başka bir bölünmede %84 çıktı. Ekip “model kötüleşti” diye endişelendi. Hiçbir şey kötüleşmemişti. Bunlar aynı parametrenin iki farklı istatistik tahminiydi ve doğal değişkenlik içindeydiler. İstatistik bilgisi olmayan biri bu iki sayıyı farklı gerçekler sanır.
Ders 4 Kontrol Listesi
- Parametre ve istatistik farkını örneklerle anlatabiliyorum.
- μ, σ, x̄, s, p, p̂ gösterimlerinin ne anlama geldiğini biliyorum.
- Örneklem varyansında neden n-1 kullanıldığını sezgisel olarak açıklayabiliyorum.
- NumPy ve R’ın varyans hesabındaki varsayılan farkını biliyorum.
- Bir istatistiğin her örneklemde değişebileceğini kabul ediyorum.
Sıkça Sorulan Sorular
Parametre ve istatistik arasındaki fark nedir?
Parametre anakütleyi, istatistik örneklemi özetler. Parametre sabit ve çoğunlukla bilinmezdir. İstatistik ise örneklemden hesaplanır ve değişkendir.
Örneklem varyansı neden n-1 ile bölünür?
Örneklem ortalaması örneğin kendi verisine en yakın nokta olduğu için kareler toplamını olduğundan küçük gösterir. n-1 bu eğilimi düzeltir.
Standart sapma da n-1 ile mi hesaplanır?
Evet, örneklem standart sapması örneklem varyansının karekökü olarak alınır. Ancak karekök alındığında küçük bir yanlılık kalır. Pratikte bu fark çoğu zaman ihmal edilir.
NumPy ve Pandas neden farklı std değeri verir?
NumPy varsayılan olarak ddof=0, Pandas ise ddof=1 kullanır. İstediğin sonucu almak için ddof parametresini açıkça yaz.
Kestirim ve kestirici aynı şey midir?
Hayır. Kestirici bir formül ya da kuraldır (örneğin x̄). Kestirim ise o kuralın belirli bir örneklemdeki sayısal sonucudur.
Bir sonraki derste, veri toplanırken ortaya çıkan en sinsi sorunlara geçiyoruz: araştırma tasarımı, yanlılık (bias) ve veri toplama yöntemleri.