Anakütle (Population) vs. Örneklem (Sample) Farkı
Bir araştırma şirketi, bir seçim öncesi 1.000 kişiyle konuşup 60 milyon seçmen hakkında tahmin yürütür. Bir e-ticaret sitesi, 5.000 kullanıcıya yeni tasarımı gösterip milyonlarca kullanıcı için karar verir. Bu işin nasıl mümkün olduğunu ya da ne zaman felaketle sonuçlandığını anlamak için iki kelimeyi iyice oturtmamız lazım: anakütle ve örneklem.
Anakütle (Population) Nedir?
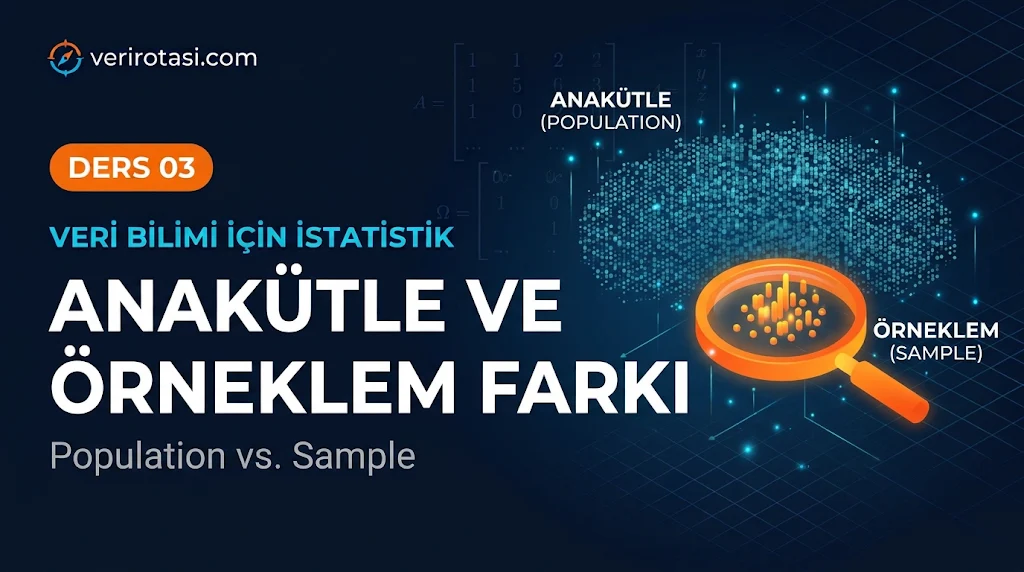
Anakütle, ilgilendiğin tüm birimlerin oluşturduğu eksiksiz kümedir. “Birim” bir kişi, bir işlem, bir cihaz ya da bir ürün olabilir.
Örnekler:
- Türkiye’deki tüm 18 yaş üstü seçmenler
- Bir uygulamanın şu ana kadar kaydolmuş tüm kullanıcıları
- Bir fabrikanın bu ay ürettiği tüm cıvatalar
Anakütle çoğu zaman ulaşılamaz ya da ölçmesi çok pahalıdır. Tüm cıvataları kırarak dayanıklılığını test edersen satacak ürün kalmaz. Bu yüzden elimizde neredeyse hep bir parça vardır.
Örneklem (Sample) Nedir?
Örneklem, anakütleden seçilen ve gerçekten gözlemlediğin alt kümedir. Amaç, anakütleyi doğru temsil etmektir.
Burada iki kelime çok önemli: temsil ve seçim. Büyük bir örneklem değil, iyi seçilmiş bir örneklem değerlidir.
Büyük ama yanlı bir örneklem, küçük ve düzgün seçilmiş bir örneklemden daha kötüdür.
Bu cümleyi bir kenara yaz, ileride döneceğiz.
Neden Örneklem Kullanırız?
- Maliyet: Herkesi ölçmek çoğu zaman pahalıdır.
- Zaman: Karar bugün gerekirse tüm veriyi toplamak geç kalır.
- Yıkıcı testler: Ürünü test ederken ürünü kullanılmaz hale getirirsin.
- Pratik imkânsızlık: Anakütle sonsuz ya da sürekli akıyor olabilir (örneğin gelecekte gelecek tüm kullanıcılar).
Sayım mı, Örnekleme mi?
Tüm anakütleyi ölçmeye sayım (census) denir. Veri bilimi dünyasında ilginç bir durum var: bir şirketin veri tabanında tüm müşteri kayıtları olabilir. Bu bir sayım gibi görünür. Ama sana “gelecekteki müşteriler” soruluyorsa, elindeki veri yine o genel anakütlenin bir örneklemi sayılır. Soruyu hangi anakütle için sorduğunu açıkça belirlemek gerekir.
Veri Biliminde Bu Fark Nerede Önemli?
- Eğitim ve test ayrımı: Modelini eğitim verisi üzerinde değil, görmediği veride sınarsın. Test seti, gelecekteki anakütleyi temsil etmelidir.
- A/B testleri: Seçilen kullanıcı grubu tüm kullanıcıları temsil etmiyorsa sonuç genellenemez.
- Anketler ve geri bildirim analizi: Sadece mutlu ya da sadece çok kızgın müşteriler yanıt veriyorsa elindeki örneklem çarpıktır.
- Dağılım kayması (data drift): Canlıdaki veri, modelin eğitildiği veriden farklılaştığında örneklem artık anakütleyi yansıtmıyordur.
Uygulama: Örneklem Büyüdükçe Ne Olur?
Teoriyi bir simülasyonla somutlaştıralım. 100.000 kişilik bir anakütle hayal et. Bu kişilerin aylık harcamaları sağa çarpık bir dağılımla gelsin.
import numpy as np

rng = np.random.default_rng(42)

# Anakütle: 100.000 kişinin aylık harcaması
anakutle = rng.lognormal(mean=8.5, sigma=0.6, size=100_000)
print("Gerçek anakütle ortalaması:", round(anakutle.mean(), 1))

# Farklı örneklem büyüklükleri için 1000 deneme
for n in [10, 100, 1000]:
    ortalamalar = [rng.choice(anakutle, size=n).mean() for _ in range(1000)]
    print(f"n={n:>4} | tahminlerin ortalaması: {np.mean(ortalamalar):.1f} | "
          f"tahminlerin yayılımı: {np.std(ortalamalar):.1f}")
Çıktıda iki şeyi gözlemlemeni istiyorum:
- Her örneklem büyüklüğünde tahminlerin ortalaması gerçek değerin etrafında toplanıyor.
- n büyüdükçe tahminlerin yayılımı daralıyor. Yani tek bir örneklemden aldığın sonuç gerçeğe daha yakın düşüyor.
Bu simülasyon, Modül 5’te göreceğimiz merkezi limit teoremi ve standart hata kavramlarının ön gösterimi.
R ile de benzer bir deneme yapabilirsin:
set.seed(42)
anakutle <- rlnorm(100000, meanlog = 8.5, sdlog = 0.6)
mean(anakutle)

orneklem <- sample(anakutle, size = 100)
mean(orneklem)
Kodu birkaç kez çalıştır. Her seferinde orneklem ortalaması farklı çıkacak. Buna örnekleme değişkenliği (sampling variability) denir. Hata yapmıyorsun, doğanın işleyişi böyle.
Temsil Edilebilirlik: Örneklem Neden Çoğu Zaman Bozuk?
Örneklem ne kadar büyük olursa olsun yanlış bir yerden seçilmişse hiçbir işe yaramaz. Klasik örnek: 1936 ABD başkanlık seçimi. Literary Digest dergisi 2 milyondan fazla kişiye ulaştı ve yanlış kazananı tahmin etti. Örneklem büyüktü ama telefon ve araba sahiplerinden oluşuyordu. O dönemde bu kitle ülkenin daha varlıklı kesimiydi. Çok daha küçük bir örneklemle çalışan George Gallup ise doğru tahmini yaptı.
Bu hikâyeden çıkaracağın ders şu: örneklem büyüklüğü hatayı azaltır, ama yanlılığı (bias) azaltmaz.
Acı Tecrübe: “Tüm Verimiz Var” Yanılgısı
Bir keresinde bir bankada “kredi başvurusu onaylanan müşteriler” verisiyle risk modeli kurduk. Elimizde yüz binlerce kayıt vardı, veri çok görkemli görünüyordu. Ama reddedilen başvuruların sonucu hiç bilinmiyordu. Modeli tüm başvuru sahiplerine uygulamaya kalkınca performans dibe vurdu. Çünkü eğitim verimiz anakütlenin yalnızca “elenmiş” bir parçasıydı.
Burada gördüğün şey seçilim yanlılığı (selection bias). Bunu Ders 5’te geniş biçimde ele alacağız.
Ders 3 Kontrol Listesi
- Anakütle ve örneklemi kendi cümlelerimle tanımlayabiliyorum.
- Bir analizde “hedef anakütle”nin ne olduğunu en başta yazıya dökebiliyorum.
- Örneklem büyüklüğünün hatayı azalttığını ama yanlılığı gidermediğini biliyorum.
- Test setinin neden anakütleyi temsil etmesi gerektiğini açıklayabiliyorum.
- Örnekleme değişkenliğinin normal olduğunu ve hata olmadığını biliyorum.
Sıkça Sorulan Sorular
Anakütle ve örneklem arasındaki fark nedir?
Anakütle ilgilendiğin tüm birimlerin tamamıdır. Örneklem ise bu tamamın içinden seçilip gözlemlenen parçadır.
İyi bir örneklem nasıl olmalı?
Anakütleyi temsil etmeli, rastgele ya da kontrollü bir yöntemle seçilmeli ve amaca yetecek büyüklükte olmalıdır.
Örneklem büyüklüğü ne kadar olmalı?
Tek bir sihirli sayı yok. Hata payına, değişkenliğe ve istenen güven düzeyine bağlı. Bunu Modül 5 ve 6’da formüllerle hesaplayacağız.
Büyük veri varsa örnekleme hâlâ gerekli mi?
Evet. Veri büyük olsa bile yanlılık sorunu devam edebilir. Üstelik elindeki veri çoğu zaman gelecekteki duruma dair bir örneklemdir.
Örneklem ortalaması neden anakütle ortalamasına eşit çıkmaz?
Her örneklem rastgele bir parçadır. Seçilen parçaya göre sonuç değişir. Bu değişkenliğin ölçüsü standart hatadır.
Bir sonraki derste, bu iki kümenin özet değerlerine isim vereceğiz: parametre ve istatistik kavramlarını netleştireceğiz.