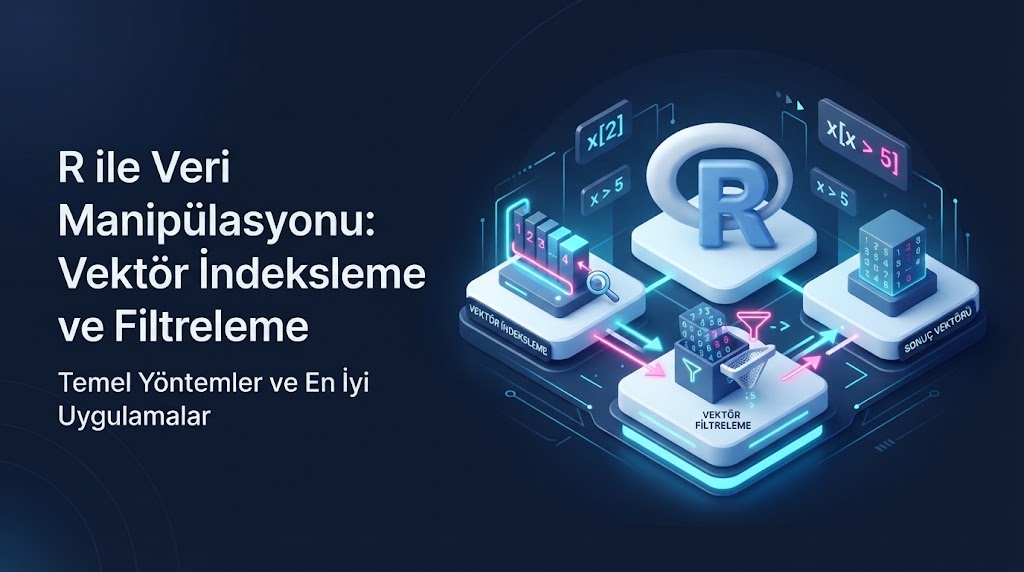
R’da Vektör İndeksleme ve Filtreleme: [ ] Kullanımı, which() ve NA Tuzağı
Vektörü oluşturdun. Şimdi onun içinden ihtiyacın olan parçayı çekmen gerekiyor. R’da bunun adı indeksleme, aracı da köşeli parantez [ ].
Veri analizinin yarısı bu iki karakterin etrafında döner. Bu yüzden tuzaklarını da baştan bileceksin: indekslerin 1’den başlaması, eksi işaretinin “hariç tut” anlamına gelmesi ve NA‘nın filtreleri sessizce bozması.
Pozitif İndeks: Konuma Göre Seçmek
x <- c(10, 20, 30, 40, 50)

x[1]          # [1] 10
x[5]          # [1] 50
x[2:4]        # [1] 20 30 40
x[c(1, 5)]    # [1] 10 50
x[c(1, 1, 2)] # [1] 10 10 20
Arka planda ne oldu? Köşeli parantez içine verdiğin sayılar, hangi konumların döndürüleceğini söyler. Aynı konumu birden fazla yazarsan R onu birden fazla kez döndürür. Sonuncu satırda 10 iki kez geldi.
R’da ilk eleman 1. konumdadır, 0. değil. Python ya da JavaScript’ten geliyorsan elin alışkanlıktan x[0] yazacak:
x[0]
# numeric(0)
Hata yok, uyarı yok. Boş bir vektör döner ve devam edersin. Kod sonradan beklenmedik bir yerde patlar.
Son Elemana Ulaşmak
x[length(x)]
# [1] 50
Sınırın Dışına Çıkmak
x[6]
# [1] NA
Olmayan bir konumu istersen R hata vermez, NA döndürür. Sıralamayı yanlış saydığında yine sessizce NA alırsın.
Negatif İndeks: Hariç Tut
x[-1]          # [1] 20 30 40 50
x[-c(1, 2)]    # [1] 30 40 50
x[-length(x)]  # [1] 10 20 30 40
Eksi işareti “bu konumları çıkar” demek. Sonuncu satır, son eleman hariç hepsini verir.
Pozitif ve negatif konumları karıştıramazsın:
x[c(-1, 2)]
# Error in x[c(-1, 2)] : only 0's may be mixed with negative subscripts
Mantıksal İndeks: Şarta Göre Filtrelemek
Asıl güç burada. x[ŞART] yazarsın, R yalnızca şartın TRUE olduğu elemanları döndürür.
x > 25
# [1] FALSE FALSE  TRUE  TRUE  TRUE

x[x > 25]
# [1] 30 40 50
Arka planda ne oldu?
x > 25her eleman içinTRUEya daFALSEüretti. Bu,xile aynı uzunlukta bir mantıksal vektör.- Köşeli parantez bu vektörü “maske” olarak kullandı.
TRUEolan konumlardaki elemanlar geçti,FALSEolanlar elendi.
Birden fazla şart kullanırken Ders 13’te gördüğümüz tek & ve | operatörlerini kullan. Çift olanlar (&&, ||) vektörlerde çalışmaz:
x[x > 15 & x < 45]     # [1] 20 30 40
x[x < 20 | x > 40]     # [1] 10 50
Bir değerin kümede olup olmadığını %in% ile sorgularsın:
sehirler <- c("Ankara", "İzmir", "Bursa", "Adana")

sehirler %in% c("Ankara", "Bursa")
# [1]  TRUE FALSE  TRUE FALSE

sehirler[sehirler %in% c("Ankara", "Bursa")]
# [1] "Ankara" "Bursa"
Tuzak: Kısa Mantıksal Vektör Tekrarlanır
x[c(TRUE, FALSE)]
# [1] 10 30 50
Mantıksal vektör x‘ten kısaysa R onu baştan tekrarlar (Ders 18’deki recycling). Burada TRUE FALSE TRUE FALSE TRUE gibi davrandı ve 1., 3., 5. elemanları seçti. Bazen işe yarar, çoğu zaman yanlışlıkla olur.
En Sinsi Tuzak: NA ile Filtreleme
y <- c(5, NA, 15, 25)

y[y > 10]
# [1] NA 15 25
Beklediğin sonuç 15 25 idi. Peki o NA nereden çıktı?
Arka planda ne oldu? NA > 10 sorusunun cevabı TRUE ya da FALSE değil, yine NA. Maske FALSE NA TRUE TRUE oldu. Köşeli parantez maskedeki NA ile karşılaşınca “bu elemanın seçilip seçilmediğini bilemiyorum” deyip sonuca bir NA yazdı. Hata da yok, uyarı da.
Acı tecrübe: Eksik veriler içeren bir sütunu filtrelediğimde satır sayısı beklediğimden fazla çıkmıştı. Aradığımı bulmam yarım gün sürdü, çünkü kimse
NA‘nın filtre sonucuna da sızabileceğini söylememişti.
Üç güvenli çözüm var:
y[!is.na(y) & y > 10]     # eksikleri önce ele
# [1] 15 25

y[which(y > 10)]          # which() NA'ları otomatik atlar
# [1] 15 25

which(y > 10)             # konumları verir
# [1] 3 4
which() yalnızca TRUE olan konumların numarasını döndürür. NA olanlar TRUE olmadığından dışarıda kalır. En çok bu yüzden vektör filtrelerinde işe yarar.
Benzer bir yardımcı da which.max() ve which.min(). Ders 18’de görmüştük.
İsimle İndeksleme
notlar <- c(Ali = 70, Ayşe = 85, Mehmet = 60)

notlar["Ali"]
# Ali
#  70

notlar[c("Ali", "Mehmet")]
#    Ali Mehmet
#     70     60

notlar["Zeynep"]
# <NA>
#   NA
Olmayan bir isim hata vermez, <NA> etiketli bir NA döndürür. Yazım hatası yaptığında farkına varman gerekir.
Sadece değeri istersen çift köşeli parantez kullanabilirsin:
notlar[["Ali"]]
# [1] 70
[ ] isimli kapsayıcıyı korur, [[ ]] ise içindeki değeri tek başına çıkarır. Bu fark listelerde (Ders 21) çok daha önemli hale gelecek.
Değiştirmek: Atama ile İndeksleme
Aynı sözdizimiyle değerleri değiştirebilirsin:
v <- c(1, 2, 3)

v[2] <- 99
v
# [1]  1 99  3

v[5] <- 9         # olmayan konuma yazarsan vektör uzar
v
# [1]  1 99  3 NA  9
Aradaki boşluk NA ile dolar. Hata yok, vektör sessizce büyüdü.
Eksik değerleri doldurmak için:
y <- c(5, NA, 15, 25)
y[is.na(y)] <- mean(y, na.rm = TRUE)
y
# [1]  5 15 15 25
Ortalama (5 + 15 + 25) / 3 = 15. Bu yöntem pratik ama istatistiksel olarak her zaman doğru değildir. Eksik veriyle nasıl başa çıkılacağını Ders 40’ta ayrıntılı konuşacağız.
head() ve tail()
x <- c(10, 20, 30, 40, 50)

head(x, 3)    # [1] 10 20 30
tail(x, 2)    # [1] 40 50
head(x, -1)   # [1] 10 20 30 40
Büyük veriyi tanırken ilk ve son satırlara bakmak için kullanışlı. Negatif sayı “sondan şu kadarı hariç” anlamına gelir.
Uygulama: Sıcak Günler
sicaklik <- c(Pzt = 18, Sal = 22, Çar = 31, Per = 27, Cum = 35)

sicaklik[sicaklik > 30]
# Çar Cum
#  31  35

names(sicaklik)[sicaklik > 30]
# [1] "Çar" "Cum"

sum(sicaklik > 30)
# [1] 2

mean(sicaklik)
# [1] 26.6
İlk satır hem günleri hem değerleri verir. İkinci satırda names() ile isimleri alıp aynı maskeyle filtreledik. Üçüncü satır kaç günün 30 dereceyi geçtiğini, dördüncü satır ortalama sıcaklığı hesaplar.
Kontrol Listesi
- ☐ İndekslerin 1’den başladığını ve
x[0]‘ın boş vektör döndürdüğünü biliyorum. - ☐
x[-1]ifadesinin “ilk elemanı çıkar” anlamına geldiğini biliyorum. - ☐ Mantıksal filtrede
&ve|kullanıyorum,&&ve||kullanmıyorum. - ☐
NAiçeren vektörü filtrelerkenwhich()ya da!is.na()ekliyorum. - ☐ Olmayan konum ya da isim istediğimde
NAdöneceğini hatırlıyorum. - ☐
[ ]ile[[ ]]arasındaki farkı biliyorum.
Sıkça Sorulan Sorular
R’da vektörden eleman nasıl seçilir?
Köşeli parantezle: x[2] ikinci elemanı, x[2:4] ikinciden dördüncüye kadarı, x[x > 10] 10’dan büyük olanları seçer.
R’da indeks neden 1’den başlar?
R’ın tasarım tercihidir. İstatistik ve matematik geleneğiyle uyumludur. İlk elemana x[1] ile ulaşırsın.
R’da eksi indeks ne işe yarar?
Belirtilen konumları hariç tutar. x[-1] ilk eleman dışındaki hepsini döndürür.
Filtre sonucunda neden NA görüyorum?
Maskeyi oluşturan karşılaştırma NA içeren elemanda NA döndürür. Çözüm olarak x[!is.na(x) & x > 10] ya da x[which(x > 10)] kullan.
which() ne işe yarar?
Bir mantıksal vektörde TRUE olan konumların numaralarını döndürür. NA olan konumlar dışarıda kalır.
Vektörlerle ve indekslemeyle iyice haşır neşir olduktan sonra bir boyut ekliyoruz. Bir sonraki derste satır ve sütunlardan oluşan matrisleri ve üç boyutlu dizileri (arrays) göreceğiz.